学习呦
上下文工程 Context Engineering
概念
上下文是用户提示词、系统提示词、记忆、RAG 库、工具调用结果的汇总信息
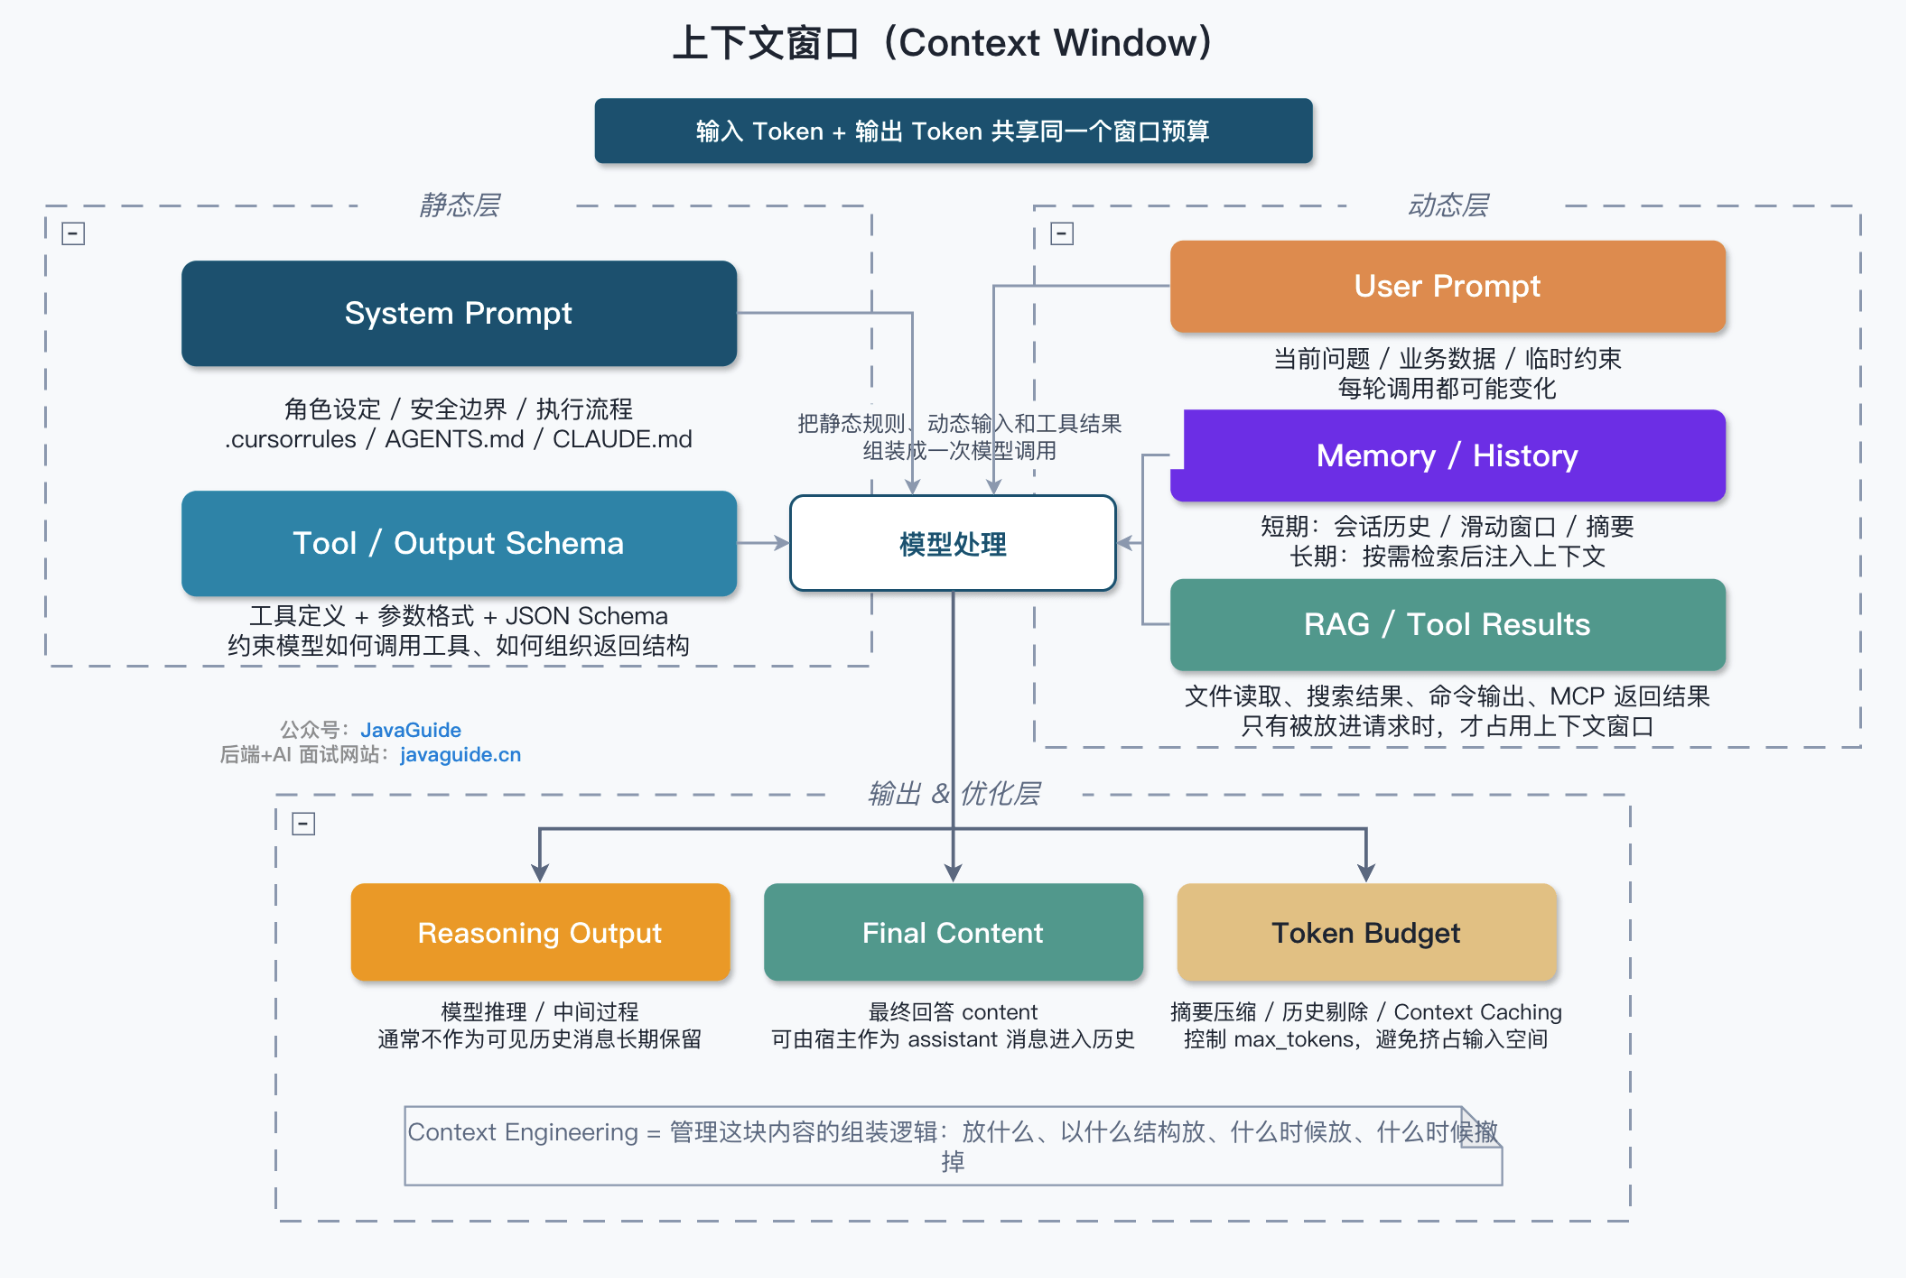
上下文限制为模型限制,现在 2026.6 的模型最大为 2M
问题
大模型会更关注上下文的开头及结尾(Lost in the Middle)中间部分会犯迷糊,具体解释如下
在 Transformer 里,模型不是像人一样一行一行读文本的。它通过 Attention 去判断:当前这个问题应该重点关注上下文里的哪些内容。你可以把 Attention 理解成一种“相关性打分”。比如你问“这个接口为什么会超时”,模型就要在上下文里找跟接口、超时、日志、SQL、缓存、外部依赖相关的信息。上下文短的时候干扰少,更容易找到重点
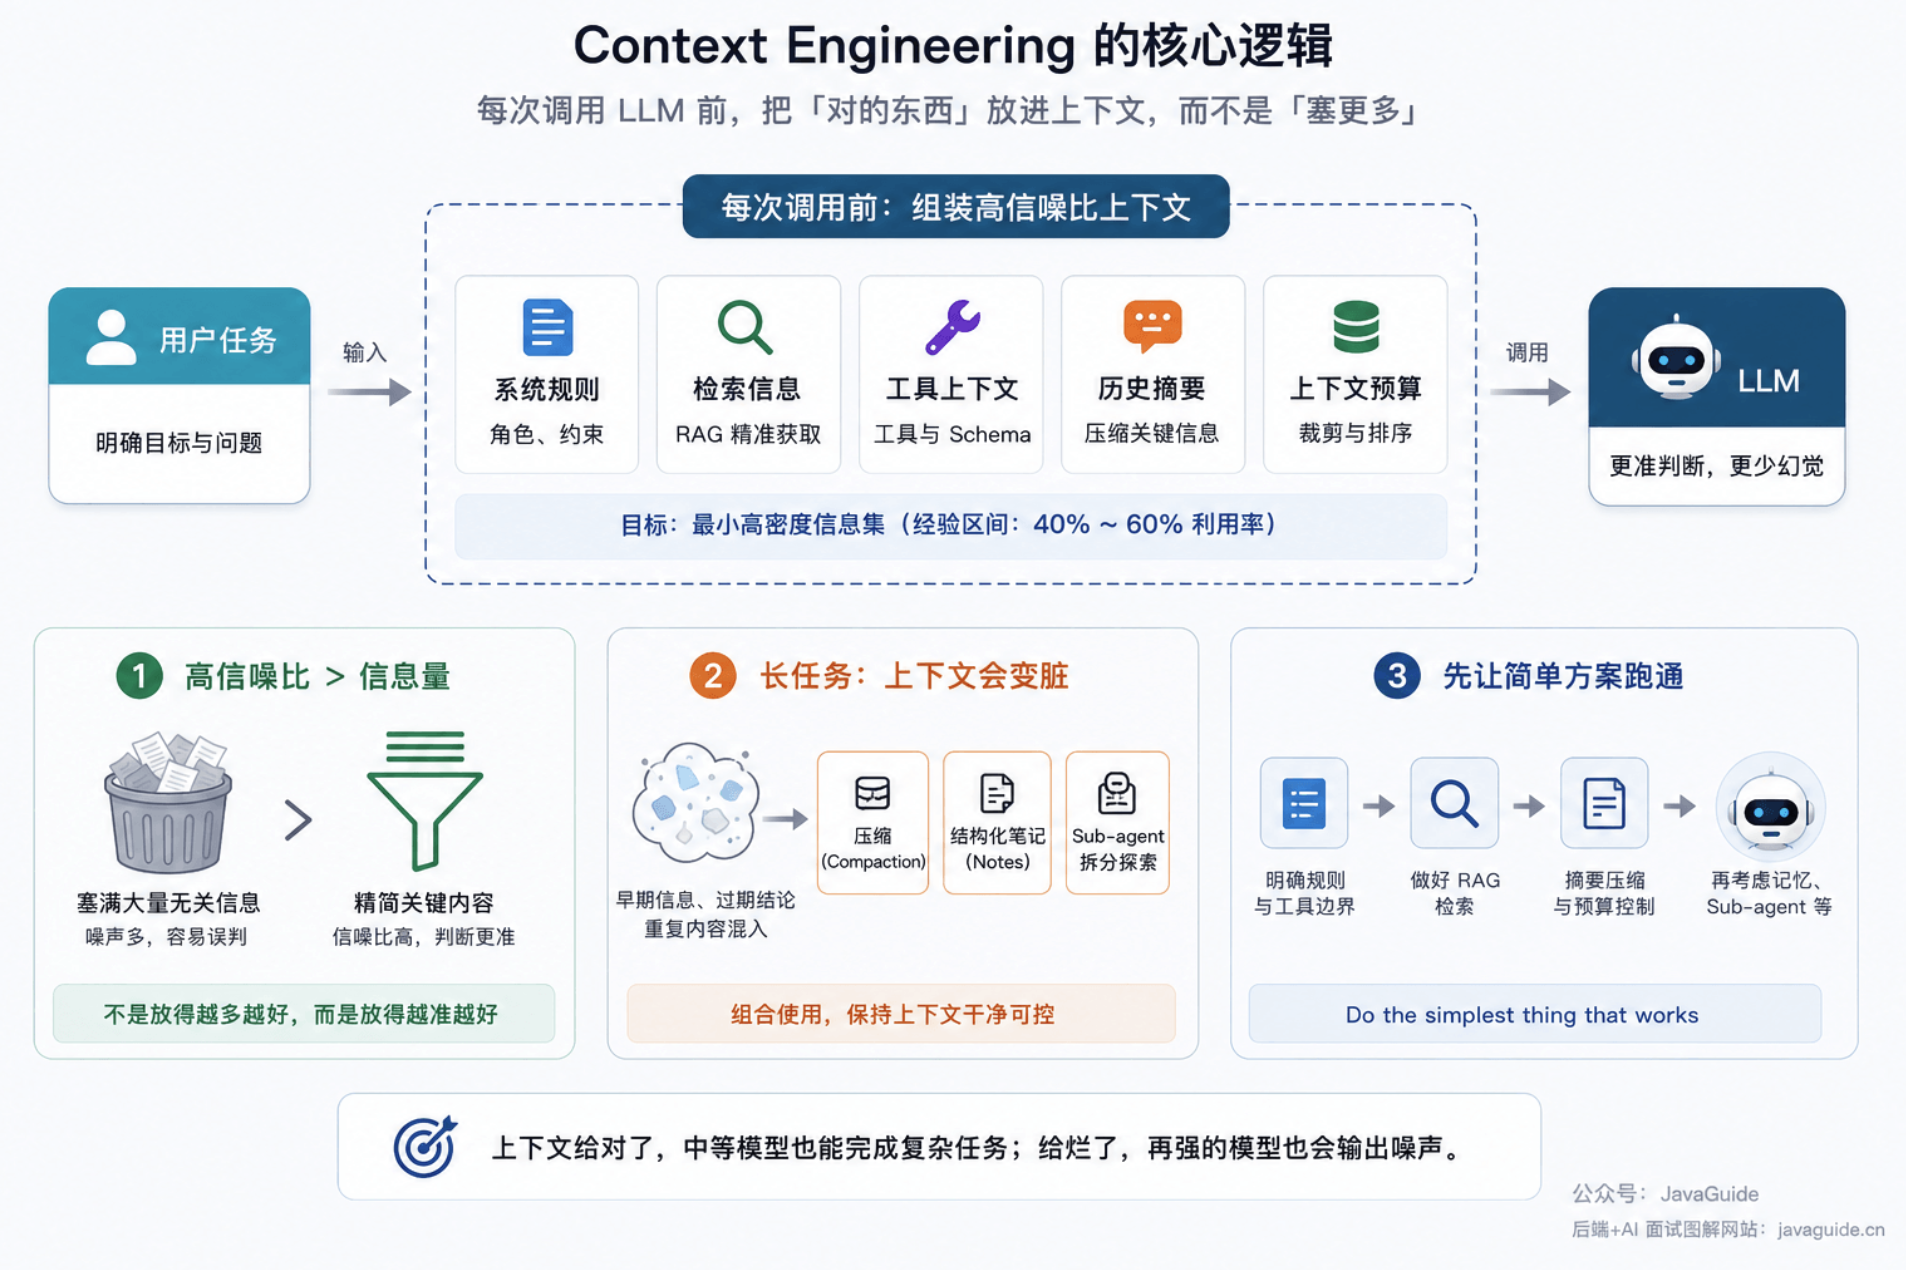
研究实验表明,最佳的上下文长度最好是最大上下文窗口的 40%-60%,能保证大模型输出准确,不产生幻觉,但阈值并非绝对值
和提示词Prompt工程的区别
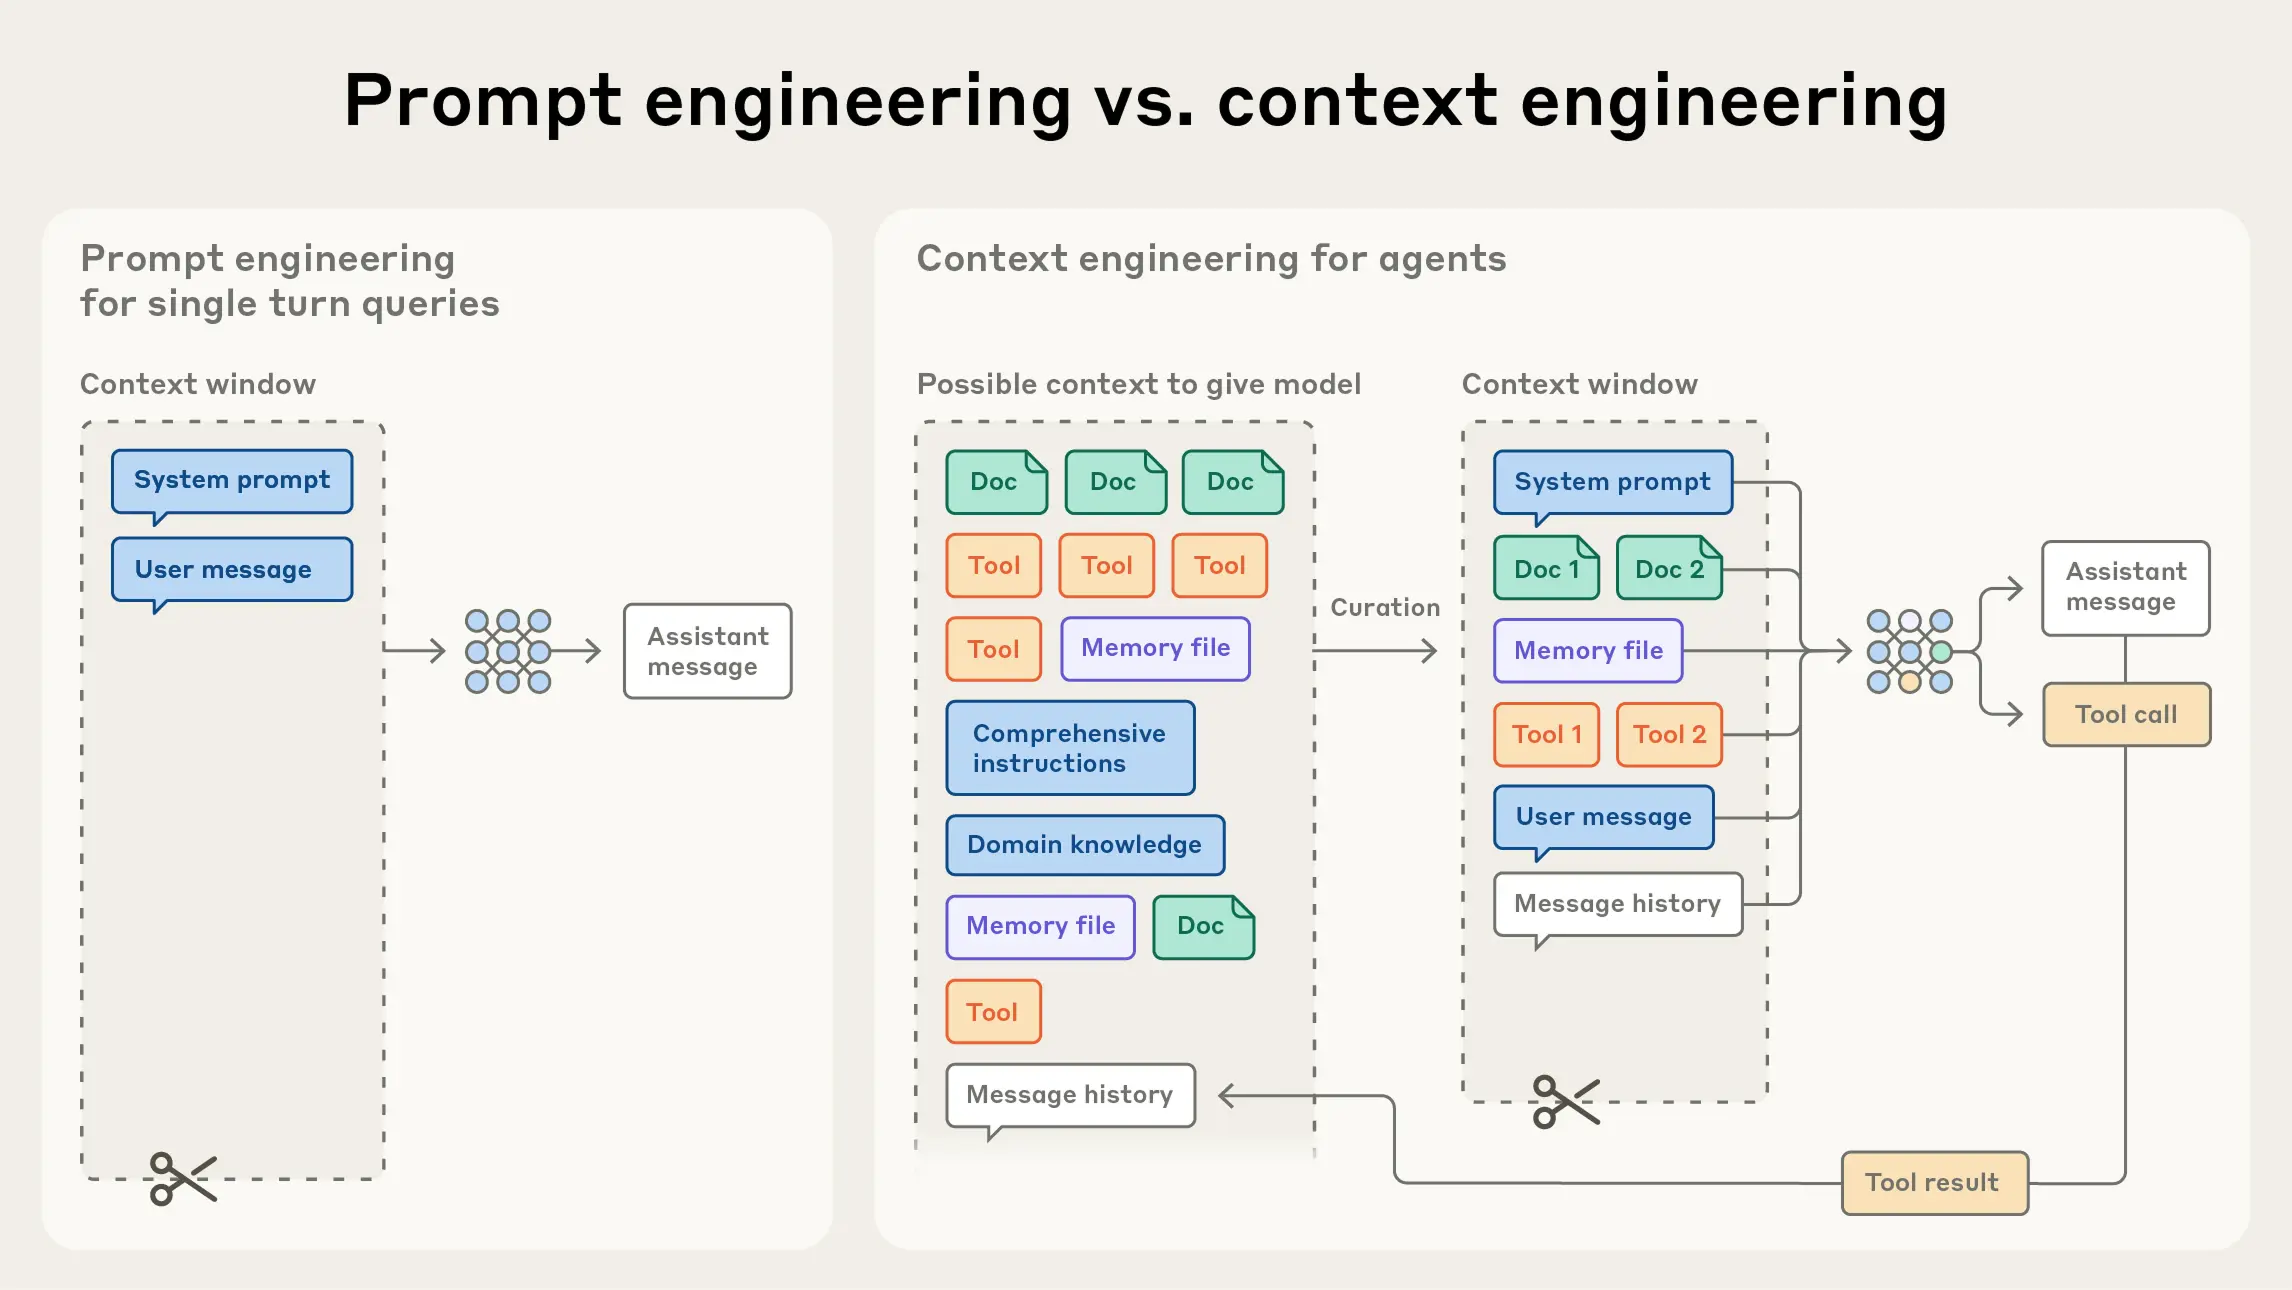
控制上下文
控制输入
让用户按照提示词工程去编写提示词,并控制 RAG、记忆信息的检索范围,不要检索所有信息,调用工具后的输出要控制接收的结果,比如使用输出结果字段筛选来保留有效的信息
压缩排序
存在历史上下文要压缩并提取摘要,去除上下文中冗余信息,只保留关键部分。设定上下文中各个部分的优先级,毕竟大模型对开头和结尾更敏感