Skill 和 Tool
<<<<<<< HEAD
什么是Skills
一、概念
有些任务不是调用一个原子工具就能完成的。比如“排查数据库慢查询”,得先读日志、跑分析脚本、对照团队规范给出建议。如果每次都从零开始,Agent 的输出既不稳定,也没法复用。
这就是 Skill 要解决的问题。Skill 更像一份可调用的经验包:把一类任务的执行顺序、约束条件和踩坑记录写下来,让 Agent 在判断当前任务命中时才把它读进来,而不是启动就全部塞进上下文。
二、为什么需要这种新范式
=======
什么是Skills?为什么说Skill是被”理解”而不是被”执行”的?
一、简介
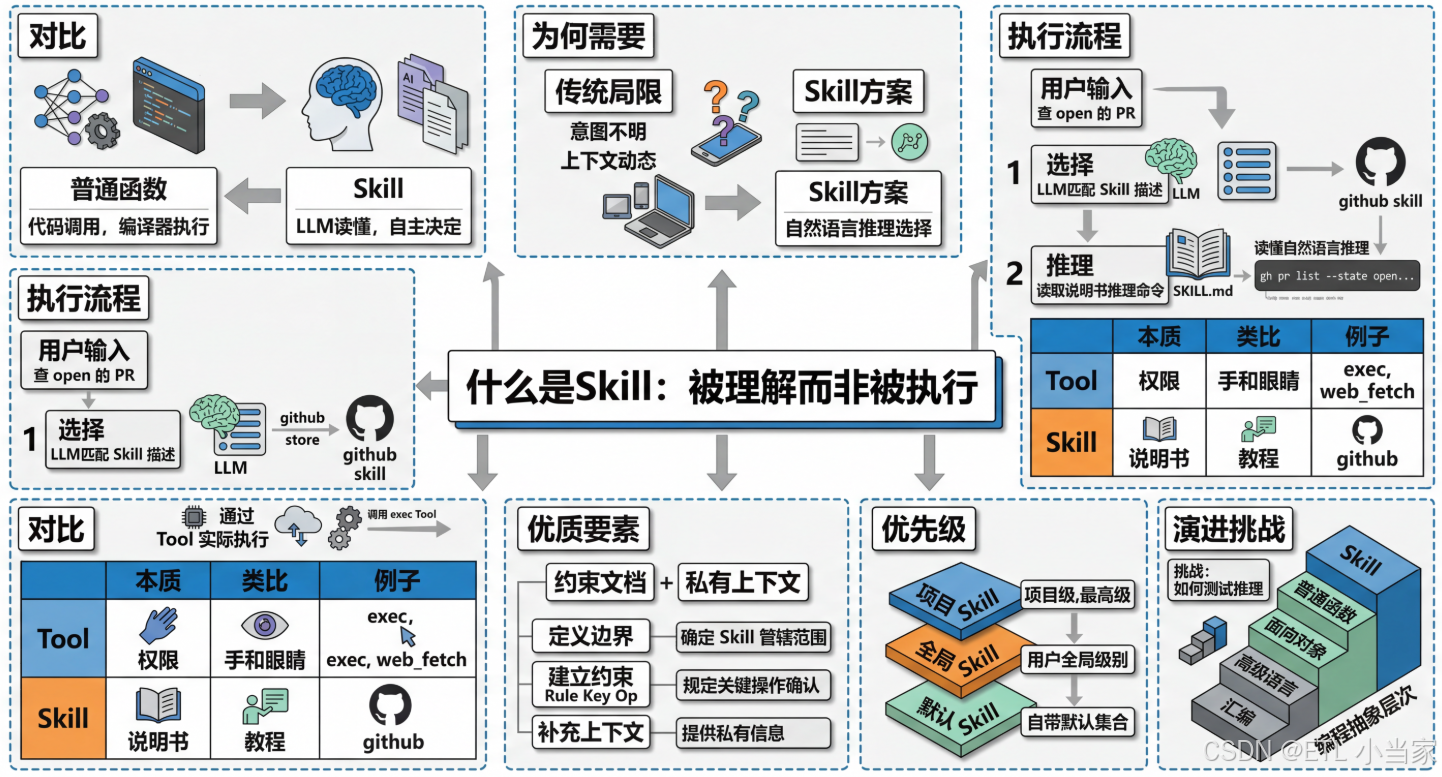
Skill 是一份写给 AI 看的”操作说明书”,它告诉 Agent 在什么情况下该做什么事。这听起来简单,但背后隐藏着一个根本性的范式转变:
普通函数:被代码调用,编译器知道何时执行
Skill:被 LLM 的推理过程”读懂”后决定要不要用
说人话就是:想象你教一个新员工做事。传统编程就像给他一本详细的操作手册,每一步都写死;而 Skill 更像是给他一个任务描述和一些指导原则,让他自己判断在什么情况下该采取什么行动。这就是”被执行”和”被理解”的本质区别。
二、为什么需要这种新范式?
origin/main
传统函数的局限性
在传统的软件开发中,函数调用是确定性的:
代码语言:Python
自动换行
AI代码解释
# 你在代码里明确写这一行 |
编译器或解释器知道这是在调用一个函数,参数是什么,返回值是什么。但这种模式在 AI Agent 场景下遇到了问题:
用户意图不明确:用户说”帮我看看有什么新消息”,这可能涉及邮件、社交媒体、即时通讯等多个渠道
上下文动态变化:同样的”查天气”指令,在不同时间、地点、场景下可能需要不同的处理方式
组合爆炸:为每一种可能的用户表达方式写一个函数是不可能的
Skill 的解决方案
<<<<<<< HEAD
传统 Toolkits(黑盒)
把多个原子工具在代码层封装成一个高阶工具,对外只暴露 JSON Schema,LLM 看不到内部执行路径。推理步骤少、Token 消耗低,适合逻辑固定的场景Agent Skills(白盒)
以SKILL.md为核心的自然语言指令集。每个 Skill 是一个独立文件夹
AI代码解释
======= |
origin/main
name: github
description: Interact with GitHub repositories — create issues, review PRs, check CI status, and manage branches.
When to use this skill
Use when the user mentions GitHub, pull requests, issues, CI/CD, or asks to review / merge / create code changes.
LLM 在推理时会"看到"所有可用的 Skill 描述,然后根据当前上下文**自主判断**是否需要激活某个 Skill。
---
## 三、Skill 的完整执行链路
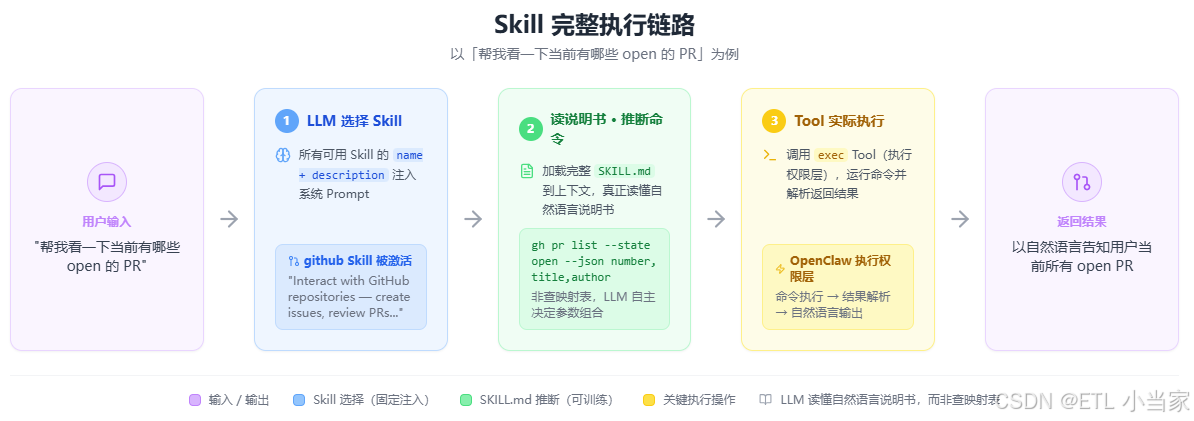
让我们通过一个具体例子来看 Skill 是如何工作的:
### 用户输入
> "帮我看一下当前有哪些 open 的 PR"
### 执行过程
#### 第一步:LLM 选择 Skill
- OpenClaw 将所有可用 Skill 的 `name + description` 注入到系统 Prompt
- LLM 读到 github Skill 的描述:"Interact with GitHub repositories — create issues, review PRs..."
- 判断这与"看 PR"语义匹配,激活 github Skill
#### 第二步:LLM 读取说明书并推断命令
- LLM 加载完整的 SKILL.md 内容到上下文
- 读到说明书中写的:`List open PRs: gh pr list --state open --json number,title,author`
- **关键点**:LLM 不是查函数映射表,而是真正读懂了自然语言说明书,自己决定参数组合
#### 第三步:通过 Tool 实际执行
- LLM 调用 `exec` Tool(OpenClaw 的执行权限层)
- 执行命令:`gh pr list --state open --json number,title,author`
- 解析返回结果,用自然语言告诉用户
---
## 四、Skill vs Tool:容易混淆的概念
|概念|本质|类比|例子|
|---|---|---|---|
|**Tool**|执行权限|你的手和眼睛|`exec`(执行shell命令)、`web_fetch`(读取网页)|
|**Skill**|操作说明书|教你怎么用手的教程|`github`(教Agent怎么用gh CLI)|
**重要区别**:
- 有 Tool 没 Skill:Agent 有手但不知道怎么干活
- 有 Skill 没 Tool:Agent 知道该做什么但没有能力执行
这就是为什么安装一个 Skill 并不自动赋予 Agent 新的权限——你还需要确保相应的 Tool 已经启用。
---
## 五、一份好的 Skill 应该包含什么?
### 不是命令大全
很多人误以为 Skill 需要把每一条命令都列出来,这是不对的。LLM 本身就有大量关于 CLI 工具的知识(来自训练数据)。
### 而是约束文档 + 私有上下文
一份好的 Skill 应该做三件事:
|作用|说明|举例|
|---|---|---|
|**定义边界**|告诉 LLM 这个 Skill 管什么、不管什么|"只操作 GitHub,不要操作本地 git"|
|**建立约束**|规定哪些操作必须确认,哪些可以直接执行|"merge/delete 前必须让用户确认"|
|**补充上下文**|提供 LLM 不知道的私有信息|公司的 repo 命名规范、特定的 label 约定|
---
## 六、Skill 的优先级机制
OpenClaw 的 Skill 有三个来源,优先级从高到低:
1. **Workspace Skill**:当前项目目录下的 `skills/` 文件夹,优先级最高
2. **Managed Skill**:`~/.openclaw/skills/`,用户级别的全局 Skill
3. **Bundled Skill**:OpenClaw 自带的默认 Skill 集合
这个设计让你可以用同名文件覆盖官方 Skill 的行为——类似于面向对象里的方法重写,但操作对象是自然语言说明书。
---
## 七、编程抽象层次的演进
Skill 的设计揭示了一个更深层的趋势:**编程的抽象层次在上升**。
- **汇编 → 高级语言**:隐藏硬件细节
- **面向过程 → 面向对象**:隐藏数据结构细节
- **函数 → Skill**:隐藏"何时调用"的决策细节
但这也带来了新的挑战:**如何测试一个"被理解"而不是"被执行"的接口**?传统的单元测试无法验证 Skill 是否会在"正确的时候"被调用,因为这取决于 LLM 的推理,而推理不是确定性的。
这是 Skill 开发者需要面对的新课题,也是 AI 编程范式带来的根本性改变。