学习呦
记忆系统 Memory
Agent 超过上下文的会话窗口后,就会自动丢掉以前的记忆,很像内存满了自然要释放一些内存,区别在于 Agent 是按照时间丢弃的
需要一套能持久化会话的系统,称之为 Agent 记忆系统
两个问题
- 跨上下文,多个会话,Agent 之间的记忆共享
- 记忆存储和管理方式
Agent 的遗忘曲线
了解记忆的生命周期,在于理解每一次和 Agent 会话中产生的记忆及 Agent 的遗忘曲线
编码(Encode) → 存储(Storage) → 提取(Retrieval) → 巩固(Consolidation) → 反思(Reflection) → 遗忘(Forgetting) |
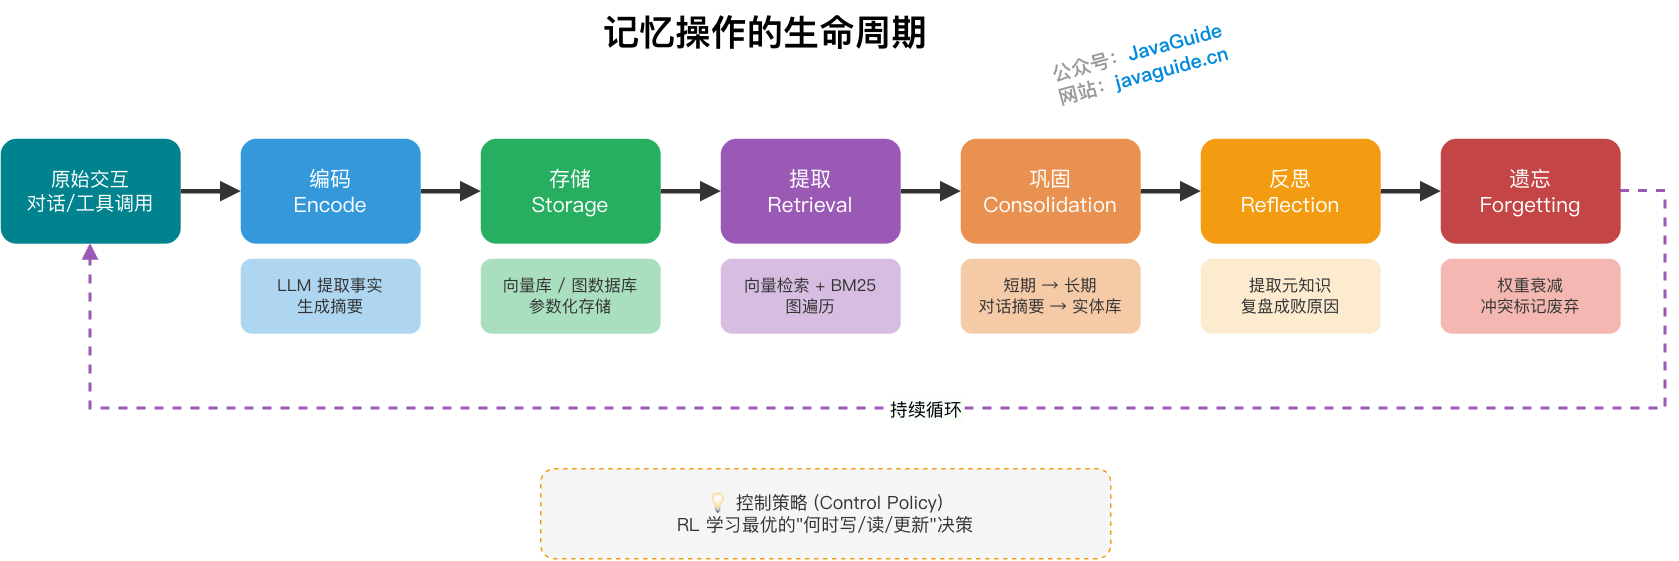
现代大模型的上下文token 一般在 2M 左右,上下文的信息包括从记忆中检索的信息,从提示词中检索的信息,工具调用产生的信息这些,都成为短期记忆,只在当前上下文中有效
基于文件系统(filesystem-backed)的记忆,持久化到磁盘文件中的信息,且需要Agent 自己去检索的信息,都成为 长期记忆
记忆管理
包括记忆的持久化,记忆的更新机制,记忆的清理与遗忘机制
记忆持久化
持久化的数据一般为向量,需要向量数据库
记忆更新、遗忘机制
记忆需要反思、合并、清理、遗忘,否则库越大,噪声越大
记忆需要从流水账中提取出可复用的 rules,用户偏好以及教训,反复提取,多次总结,遗忘掉不需要的记忆
应用方向
工具自动生成的记忆文件
codebuddy、claude code 等都有专属的 .md 结尾的记忆文件,基本都可以通过 /init命令,创建项目级别、个人级别等的记忆文件
这种记忆文件主要是针对项目的描述,使用的工具库,依赖,基本的逻辑,项目的结构等架构方面的信息,不包括具体的实现细节
个人偏好
可以使用 rules,配置项目级别、个人用户的规则文件,这些文件可以被各家 Agent 识别并应用到会话上下文当中
开发
使用 LangChain等大模型开发框架,实现记忆控制,而不是交给本地 cli agent 去管理